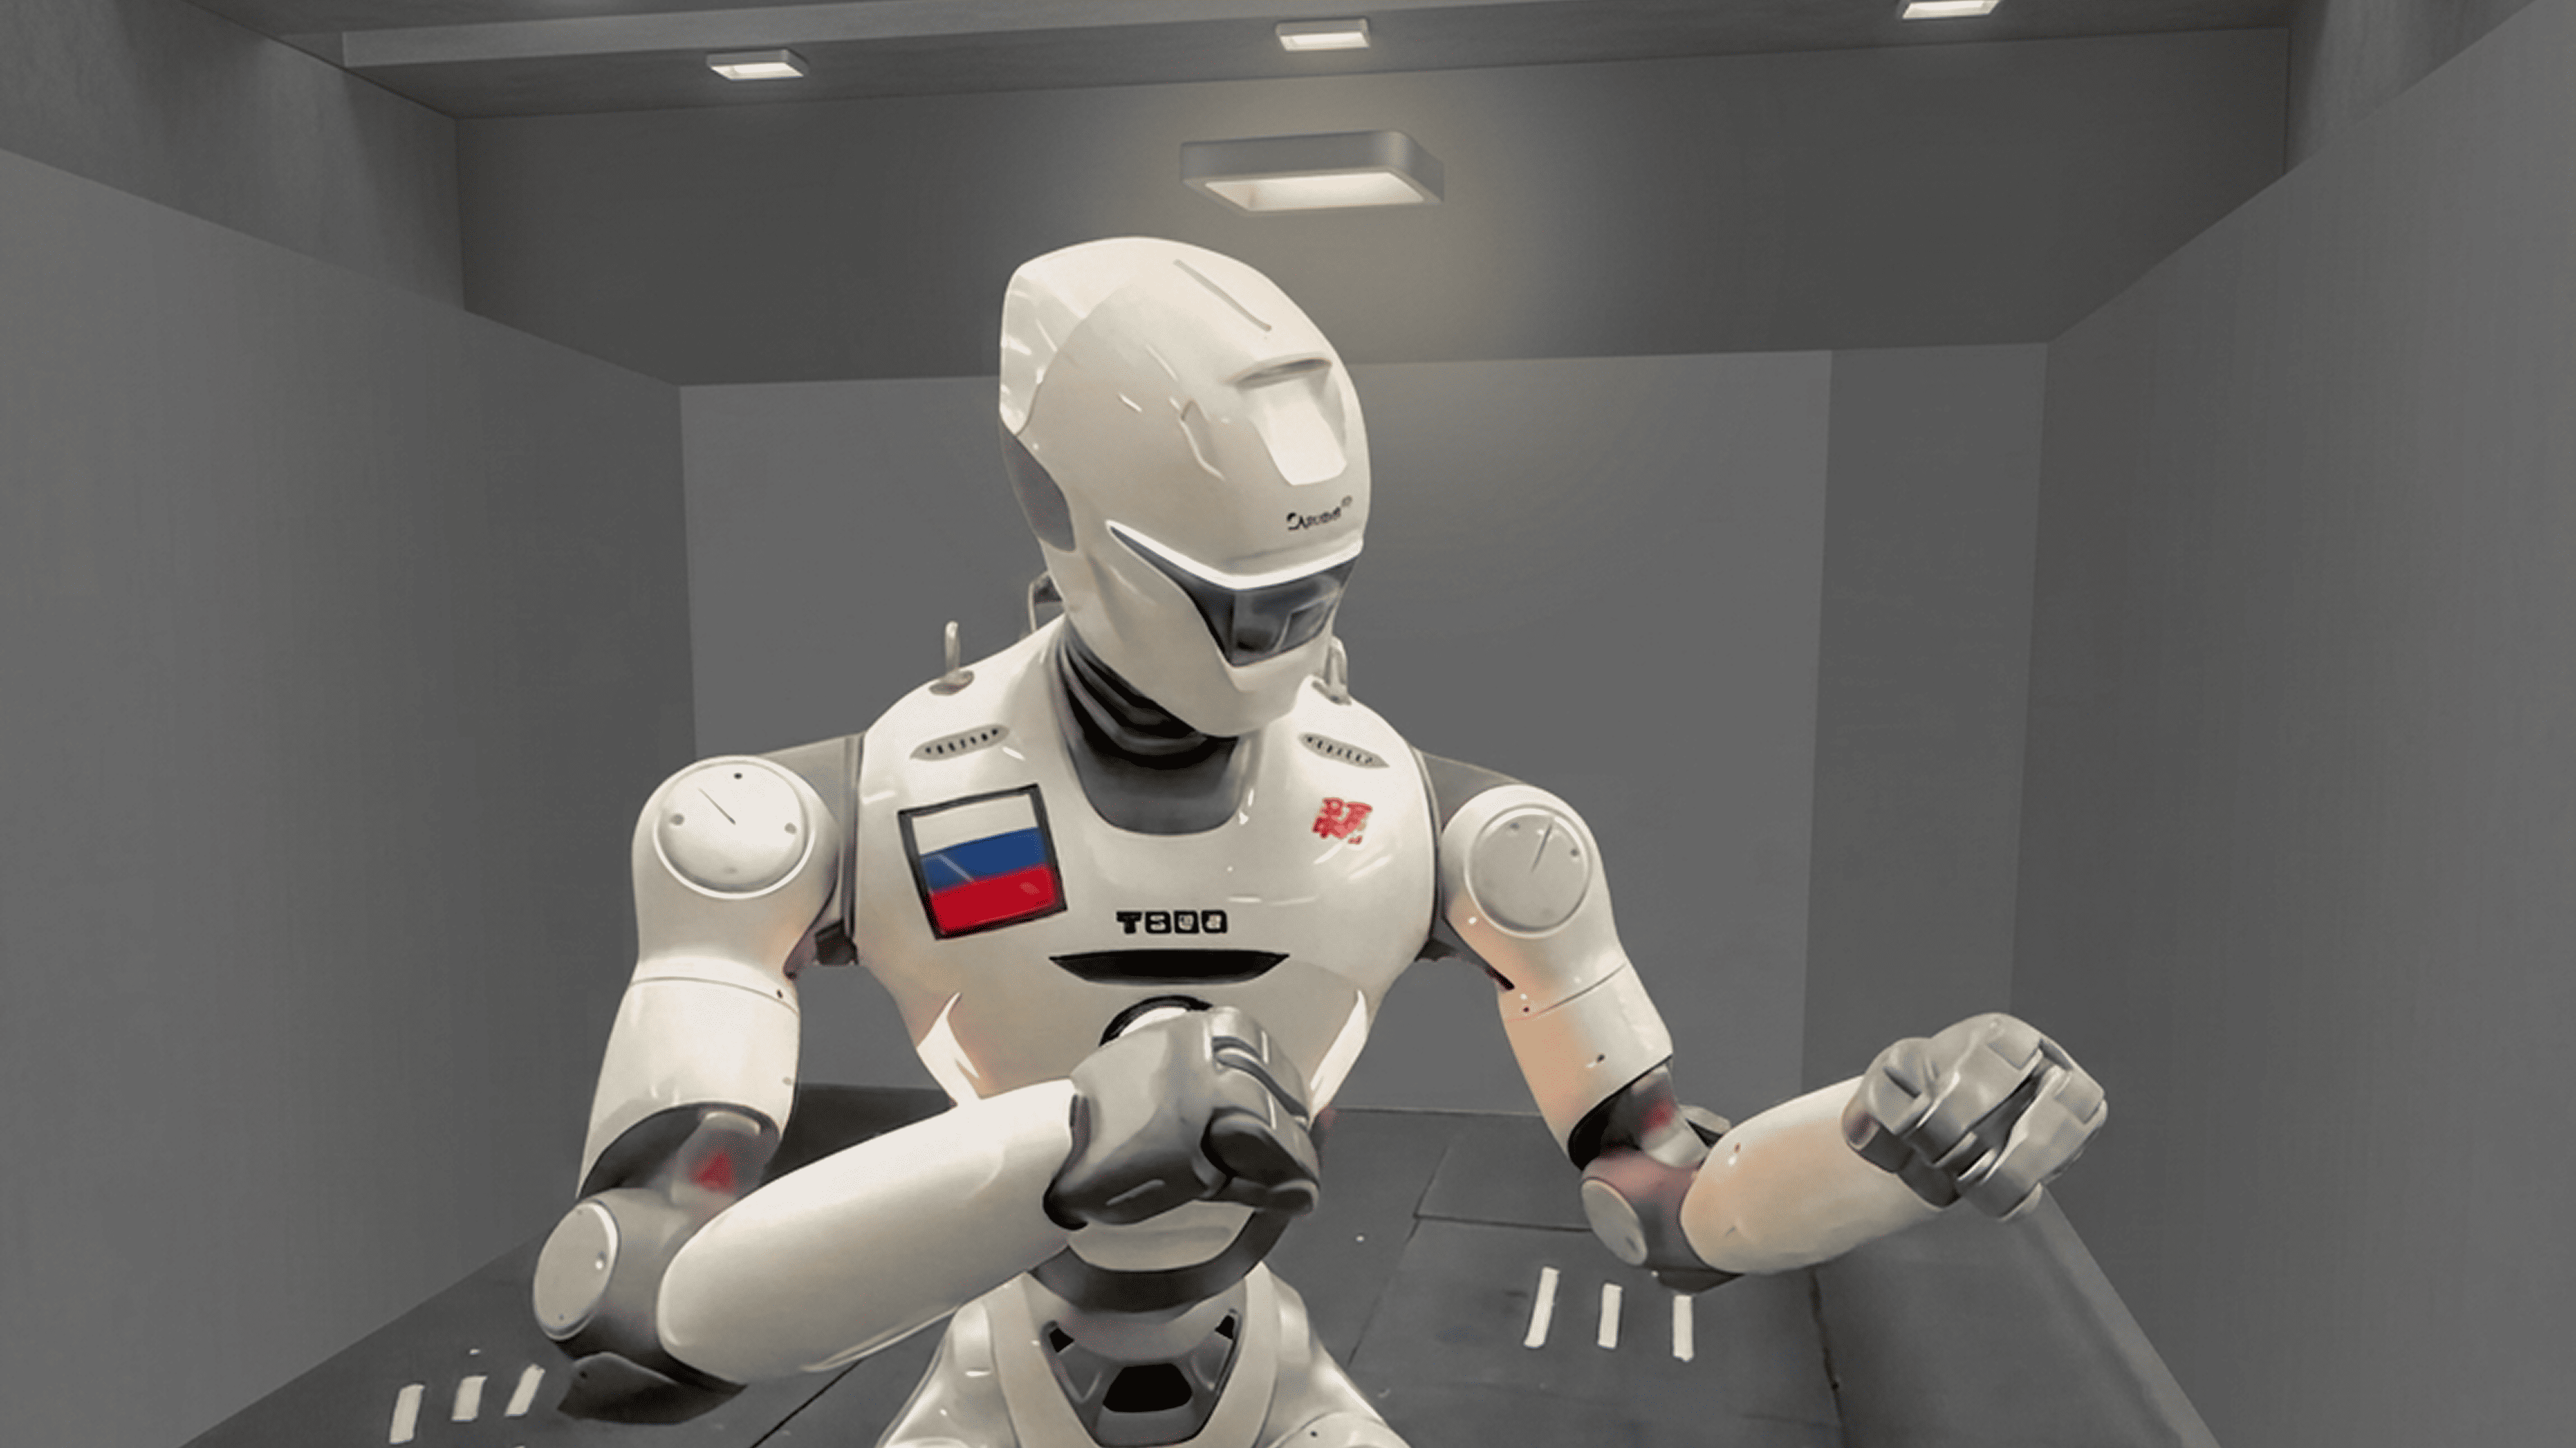
Чтобы человекоподобный робот мог самостоятельно двигаться и действовать на ринге, недостаточно запрограммировать набор отдельных движений. Его необходимо научить управлять своим телом и адаптироваться к изменяющейся ситуации.
Именно такую задачу решает команда MindRobots, которая готовит человекоподобного робота к участию в международной лиге по боям роботов URKL (Ultimate Robot Knockout Legend), организованной китайской компанией Engine AI.
Для обучения робота команда использует Reinforcement Learning (RL) — обучение с подкреплением. Модель многократно выполняет действия в виртуальной среде, получает оценку результата и корректирует своё поведение. Такой подход требует постоянных вычислений на графических процессорах (GPU).
Мы предоставили MindRobots выделенную виртуальную инфраструктуру, работающую в режиме 24×7. Сначала в проекте использовалась NVIDIA L40S, а после усложнения сценариев к ней добавили NVIDIA H200. Но обо всём по порядку.
С чего все начиналось
Компания MindRobots занимается разработкой и программированием роботов, а также их интеграцией для различных задач — от промышленных манипуляторов до автоматизированных кофеен и роботизированных решений для мероприятий.
Одним из новых направлений для команды стало участие в международной лиге URKL. Соревнования объединяют команды, работающие с человекоподобными роботами, и включают несколько этапов подготовки и состязаний.
Официальные правила URKL предусматривают оценку в том числе способности робота к восстановлению после падения, передвижению и выполнению боевых движений. Для этого недостаточно заранее задать роботу последовательность действий. Он должен уметь самостоятельно управлять движениями и адаптироваться к ситуации.
Ключевой частью подготовки робота к URKL стало обучение нейронной модели в виртуальной среде. В ней можно безопасно проводить большое количество тренировочных циклов, не подвергая физического робота износу и повреждениям. Именно здесь возникает потребность в GPU-инфраструктуре.

Почему локальных GPU оказалось недостаточно
На первом этапе команда MindRobots использовала собственные GPU. Однако для постоянного обучения модели их производительности оказалось недостаточно.
Покупка дополнительного оборудования могла решить проблему, но потребовала бы значительных капитальных затрат. Кроме стоимости самих GPU, пришлось бы приобретать серверы, организовывать их размещение, питание и охлаждение, а также самостоятельно обеспечивать эксплуатацию инфраструктуры.
Команда также рассматривала публичные платформы с арендой графических ускорителей. Их недостатком стала непредсказуемая доступность ресурсов: свободная GPU может быть доступна в один момент, а затем перераспределена между другими пользователями. Для экспериментов такой формат подходит, но при непрерывном обучении модели создаёт дополнительные ограничения.
Для MindRobots требовался другой формат: вычислительные ресурсы должны быть доступны постоянно, а их производительность должна быть предсказуемой на протяжении всего цикла обучения
Как подбирали инфраструктуру
Вместе с командой MindRobots наши специалисты рассмотрели несколько вариантов инфраструктуры — от физических серверов BareMetal до платформенного решения Inference Platform. Однако в процессе проектирования выяснилось, что эти продукты решают разные задачи.
Например, Inference Platform предназначена прежде всего для развёртывания и эксплуатации уже подготовленных ИИ-моделей. Платформа скрывает от пользователя значительную часть инфраструктурных деталей и позволяет быстро запускать модели в рабочей среде. В её основе используются GPU NVIDIA H200 SXM и высокоскоростная сеть InfiniBand.
В случае MindRobots требовалось не запускать готовую модель, а непосредственно обучать её. Поэтому команде были нужны полноценные вычислительные ресурсы с GPU, на которых можно самостоятельно настраивать окружение и запускать собственный цикл обучения.
Оптимальным вариантом стала виртуальная инфраструктура с выделенной NVIDIA L40S 48 ГБ. Такой формат позволил быстро получить необходимые мощности без закупки собственного оборудования. В «Турбо Облаке» виртуальные машины с GPU работают с выделенными физическими ускорителями через технологию Passthrough. Это позволяет использовать GPU для ресурсоёмких вычислений без разделения одного ускорителя между несколькими виртуальными машинами.
Первый этап: обучение базовым движениям
На начальном этапе модель должна была освоить базовые движения робота. Для этого команда запускала большое количество циклов обучения в виртуальной среде. Модель пробовала различные варианты управления, оценивала результат и постепенно корректировала параметры поведения.
После серии таких итераций робот научился выполнять базовые движения. Но на этом задача не закончилась.
Второй этап: виртуальный ринг
Для подготовки к поединкам разработчики создали виртуальный ринг, на котором несколько идентичных моделей могли взаимодействовать и обучаться друг у друга. Это принципиально другой уровень нагрузки. Теперь модель должна была не только воспроизводить отдельные движения, но и учиться взаимодействовать с другими роботами, анализируя действия и корректируя своё поведение.
Увеличение сложности эксперимента потребовало дополнительных вычислительных ресурсов. Поэтому к существующей инфраструктуре добавили виртуальный сервер с NVIDIA H200 141 ГБ. Эта GPU хорошо подходит для задач машинного обучения за счёт 141 ГБ памяти HBM3e и высокой пропускной способности.

Суммарно конфигурация GPU-инфраструктуры для MindRobots составила 88 vCPU, 448 ГБ RAM, 189 ГБ видеопамяти и 1 ТБ SSD. Обе виртуальные машины работают в режиме 24×7, обеспечивая постоянный доступ к вычислительным ресурсам.
От виртуального обучения к реальному результату
На сегодняшний день команда MindRobots уже прошла отборочные этапы URKL и вошла в число 16-ти сильнейших представителей международной лиги. В соревнованиях участвовали более 200 команд со всего мира.
Со стороны инфраструктуры за время проекта обеспечено более 1200 GPU-часов непрерывной работы. Полученных вычислительных мощностей хватило, чтобы перейти от базовых сценариев к более сложным экспериментам. Работа над моделью продолжается: накопленный в виртуальной среде опыт используется для дальнейшего совершенствования алгоритмов управления и подготовки робота к следующим этапам соревнований.
По текущему календарю URKL полуфиналы и глобальный финал запланированы с декабря 2026 года по январь 2027 года. Главный приз чемпионата составит 10 млн юаней.
Желаем удачи команде MindRobots и болеем за наших!
Сервисы «Турбо Облака»
Продукты, упомянутые в этом материале:

Виртуальная инфраструктура с GPU
Облачные ресурсы с мощными графическими ускорителями NVIDIA для работы с ИИ, ML, Big Data

Inference Platform
Управляемая платформа для быстрого запуска ИИ-моделей с поминутной тарификацией и автоскейлингом

Физический сервер с GPU
Выделенные серверы с графическими ускорителями для высокопроизводительных задач, включая работу с ИИ, ML, Big Data


